A masked generative graph representation learning framework empowering precise spatial domain identification
把稀疏与 dropout 当成建模对象:用 MASK、DMASK 和方向性重建逼模型使用空间邻域信息
已核验 PubMed 元数据与 PMC 开放全文(PMID 42178226;PMCID PMC13263152),并检查 Methods、Results、Fig. 1 总览图与官方代码地址;补充材料中的完整超参数表和敏感性分析未独立复算,相关表述按作者报告记录。
阅读边界: 已核验 PubMed 元数据与 PMC 开放全文(PMID 42178226;PMCID PMC13263152),并检查 Methods、Results、Fig. 1 总览图与官方代码地址;补充材料中的完整超参数表和敏感性分析未独立复算,相关表述按作者报告记录。
先给结论
这篇文章要解决的不是“再换一个聚类算法”,而是在稀疏、含 dropout 的空间转录组数据上如何学到可用的空间表示。GSG 把切片建成图,随机遮蔽一部分 spot 的表达特征,在潜空间对同一批节点二次遮蔽,只要求模型从邻域恢复表达向量的方向。值得记住的是这套数据处理与训练目标的组合方式,而不是它在某个 benchmark 上高了多少。
论文总览图
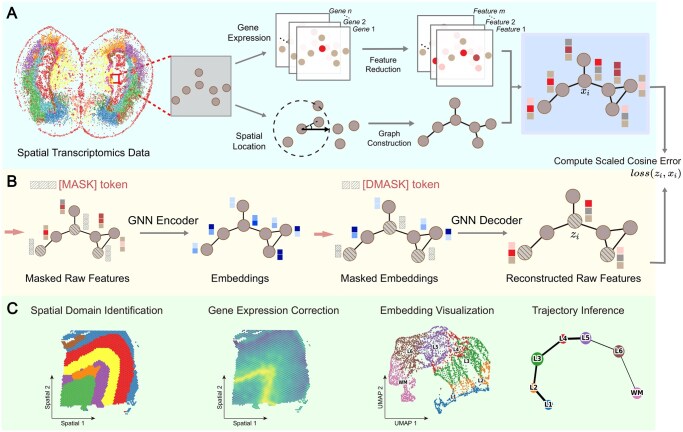
图片来源:Wang C, Zhang T, Sun H, et al. Bioinformatics 2026;42(6):btag333, Fig. 1 | 许可:CC BY 4.0 | 原图页面
目标任务与科学问题
任务定义:把组织切片上的 spot 或近单细胞测序单元,划分成表达特征与空间结构都相对一致的区域,对应皮层层次、肿瘤微环境或发育结构。
- 输入:基因表达矩阵 + 二维空间坐标。
- 输出:空间域划分,以及可复用于聚类和轨迹分析的低维表示。
- 场景:组织结构解析、肿瘤微环境刻画、发育过程分区。
为什么值得关注:难点不在聚类器,而在表示本身。
- 数据普遍稀疏并伴随 dropout,很多切片没有可靠人工域标签,监督信号存在明显缺口。
- 逐点重建的图自编码器容易连噪声一起拟合,多层邻域聚合又会过平滑,边界随之被抹掉。
- 对比学习则高度依赖正负样本与增强策略的设计。
作者据此把问题重写为:没有人工标签时,如何构造一个必须依赖邻域上下文才能完成的任务。
数据与特殊处理
论文用到的数据分三类。
- 主评测数据:公开 Visium 人类背外侧前额叶皮层(DLPFC),12 个连续切片,带 L1–L6 与白质人工注释,可作空间域参照。
- 泛化数据:Visium 乳腺癌(4 种形态学类型、20 个细分区域)、Visium 冠状面小鼠脑,以及 Slide-seqV2、Stereo-seq、seqFISH 等近单细胞分辨率平台。
- 自有数据:作者自建的人类胎儿心脏样本,用于生物学应用分析。
模态统一为「基因表达矩阵 + 空间坐标」,物种覆盖人类与小鼠。
数据处理是理解这篇文章的关键,作者写明了四步。
- 表达侧:先做过滤、归一化与对数变换,再取前 3000 个高变基因作为节点特征;规模较大时改用 PCA 降维结果。
- 空间侧:用坐标构建邻接关系,把切片变成图,节点是 spot,边表示物理邻近。
- 输入掩码:按比例 ρ 无放回采样部分节点,特征替换为可学习的
[MASK]token;作者视其为对不完整分子观测的模拟。 - 潜空间重掩码:解码前把同一批节点的潜表示换成
[DMASK]token,阻断特征直接泄露。
表达校正实验另外构造评测输入:在 12 个 DLPFC 切片上按不同比例随机遮蔽非零表达值,模拟 dropout。
边界:掩码比例 ρ 的敏感性分析与完整超参数表位于补充材料,本文未独立复算,因此不对最优取值下结论。
模型与方法创新
整体流程:图构建 → 输入掩码 → GNN 编码 → 潜表示重掩码 → GNN 解码 → 方向性重建损失。
- 编码器:多层 Graph Isomorphism Network,隐藏维度 128;Visium 小鼠脑用 2 层,其他数据用 3 层。
- 解码器:空间域任务用 GNN 解码器;表达校正任务改用较轻的 MLP 解码器,降低过平滑风险。
- 优化设置:Adam,学习率 0.001、权重衰减 0.0002;Slide-seqV2 小鼠海马训练 850 epoch,其余 500 epoch。
- 输出用途:编码器嵌入用于聚类与轨迹分析,解码器重建矩阵作为校正后的表达。
创新点不在“用了掩码”这个标签,而在三处组合。
- 把掩码变成主任务:模型必须从邻域推断被遮蔽节点,局部同质性假设由此转成可优化的自监督信号,而不是当作数据增强。
- 潜空间二次掩码:
[DMASK]针对掩码自编码器的常见退化,即编码器把目标特征直接透传给解码器,使任务塌缩成普通重建。 - 方向性损失:用 Scaled Cosine Error 替代 MSE,只约束表达向量方向一致性,并用指数 γ 提高困难样本权重。
方法谱系:掩码建模、图自编码器、GIN 与余弦型损失都不是本文首创;贡献在于按“防泄露 + 抗噪声”的目标把它们组装成针对空间组学稀疏性的链路。
关键结果(精简)
结果只作为方法是否成立的证据,不逐项罗列。
- 空间域识别:DLPFC 12 切片平均 ARI 0.554,切片 151673 为 0.651(Fig. 2B–D),皮层边界更清晰。
- 跨组织:Visium 乳腺癌 ARI 0.632(Supplementary Fig. 16A)。
- 表达校正:模拟 dropout 下 PCC 整体高于 STAGATE,高遮蔽比例时差距扩大(Fig. 3B–C);该段未给出单一汇总值。
所有可输出嵌入的方法统一使用 K-means,因此差异更可能来自表示而非后处理。
启发与思考
笔者按:最可迁移的不是 GSG 这个模型,而是它面对“稀疏 + 无标签”的处理顺序——先判断数据缺陷的形式,再把缺陷做成自监督任务,而不是先挑模型。
- 数据缺陷即监督信号:做空间组学、单细胞或任何带位置结构的测量时,都可以把 dropout 视为天然掩码来源,让邻域承担监督。
- 防泄露要显式设计:
[DMASK]提醒我们掩码任务的难度会被架构悄悄抵消;时间序列填补、图链接预测同样值得检查“模型是否走了捷径”。 - 损失要匹配噪声结构:输入被大量遮蔽时,方向一致性往往比数值精确更接近真实目标,可迁移到表达谱或光谱恢复任务。
- 评测习惯可复用:把所有嵌入方法对齐到同一聚类器再比较,比堆更多指标更能说明表示本身的差异。
实践经验:遮蔽比例本身就是难度旋钮,先用低比例验证流程,再逐步提高观察表示是否退化,比一次性定超参更容易暴露稳健性边界。
局限与复现关注点
局限:
- 方法依赖局部同质性,在肿瘤边界、连续状态梯度或空间邻近但细胞状态不同的位置会变弱,聚类分数上升不等于边界更准确。
- 人工层注释适合算 ARI,但空间域没有跨任务唯一金标准,指标提升与生物学价值不能自动等同。
- 胎儿心脏中提出的 APCDD1 属于候选线索,缺少独立队列与功能实验前不能外推为疾病机制。
复现关注点:
- 固定并记录数据版本、HVG 或 PCA 路线、邻接图规则、掩码比例 ρ、γ、层数、随机种子、K-means 初始化与聚类数。
- 报告多随机种子的均值与方差,而不是单次最佳结果。
- 可证伪实验:分别移除输入掩码、
[DMASK]与 SCE,并按边界距离分层评估;若打乱空间边后结果几乎不变,机制解释会被削弱。
论文提供了官方代码,但本文未在独立环境运行,因此不声称可一键复现。